拆解一台具身智能机器人,它的智能体系可以分为四个层次:负责理解世界、规划任务、生成动作的具身大脑;负责执行控制、动态修正、保持运动的小脑;承担机械执行、与环境交互的机器人本体;以及感知接触、精细操作、反馈数据的灵巧手与传感器。长期以来,大脑与小脑往往分属不同的计算平台,一边是x86通用处理器,一边是嵌入式AI加速模组,两套系统之间靠总线通信,既增加了整机成本,也带来了数据传输与系统同步的延迟。
一块芯片装下大小脑
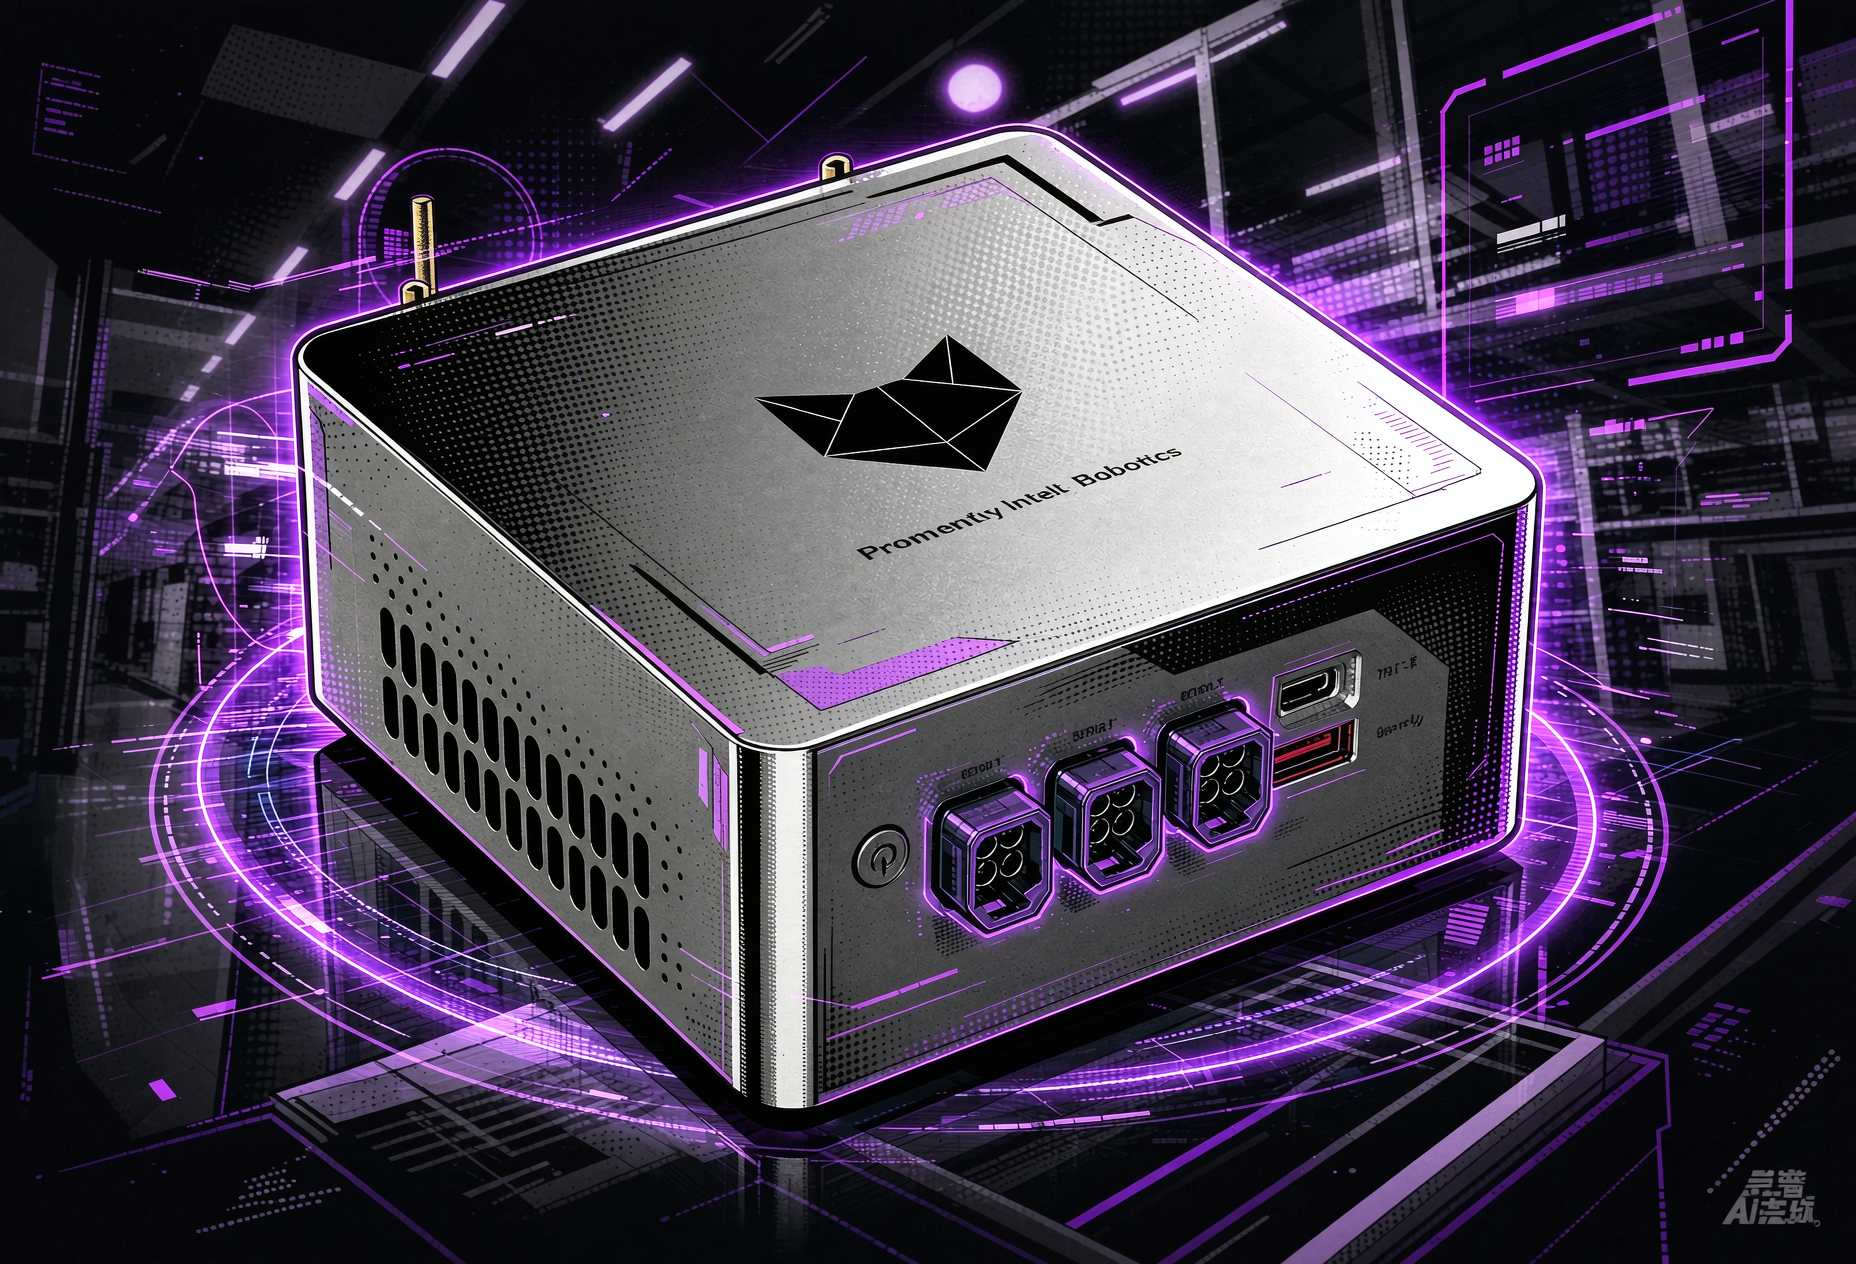
针对具身智能行业的这个现实瓶颈,英特尔与科通技术联合发布具身智能开发套件FoxJack X1。该套件基于英特尔酷睿Ultra 300系列处理器,融合大脑智能决策与小脑实时控制,为人形机器人、移动机器人与工业自主设备提供高能效开发套件。整机尺寸125×125×57.5毫米,功耗65W,封装了一个面向具身智能的完整异构计算平台,开机即用。计算底座是第三代英特尔酷睿Ultra处理器家族,基于Intel 18A工艺打造,2026年1月CES正式发布,首次为机器人等边缘场景进行了嵌入式与工业级认证,支持宽温运行与24×7全天候工作的可靠性。
180 TOPS稠密算力
以选配中的酷睿Ultra X7 358H为例,这颗处理器集成4个性能核、8个能效核与4个低功耗能效核,最高睿频达4.8GHz,配合集成锐炫显卡与NPU构成CPU加GPU加NPU的异构AI算力体系,INT8稠密算力达180 TOPS。相比业界常用的稀疏算力标称,这一数字全部由稠密计算兑现,配合LPDDR5X双通道内存,足以支撑VLA端到端模型、SLAM建图与高频运动控制在单芯片上并发运行。官方数据显示,这一平台的大语言模型推理性能达1.9倍、VLA端到端模型吞吐达4.5倍。
三种部署方式
在FoxJack X1上,大小脑融合是一套可以按需裁剪的部署体系。对于场景化人形方案,FoxJack X1以单芯片同时承接感知、决策与实时控制,取代x86主机加NX或AGX加速卡的双机组合;对于搭载Thor或RTX独立显卡的通用高端人形方案,FoxJack X1则退居AI小脑,分担部分大脑计算,让昂贵的GPU专注于大模型推理,降低整机算力配比成本;其工业实时性与虚拟化能力还能进一步替代实时MCU或多CPU,让整机架构持续简化。软件生态方面,FoxJack X1预装英特尔具身智能机器人软件开发套件,集成Preempt-RT实时内核,预装ACT操作策略、ORB-SLAM3等典型工作流与LLM、VLM、VLA参考演示,支持OpenVINO模型优化,同时支持Windows与Linux双系统。当感知、决策、控制可以在一台125毫米见方的整机内完成闭环,机器人的开发效率、整机成本与可靠性会进入新的区间。