Light Origins宣布推出Light-O1,其首个通用具身基础模型,使用从互联网视频中恢复的人类动作,为机器人学习不同任务提供可复用的起点。这家中国公司2026年8月完成了数亿元人民币的Pre-A轮融资。公司报告称,它训练了同一个40亿参数基础模型的六个版本,使用了37.5亿到1200亿多模态token之间。最大规模运行代表约10万小时的人类动作。每个版本随后分别适配到公开的第一人称人类数据、公开的宇树G1机器人数据和Light Origins自己的LightBot人形机器人数据。
预测误差随预训练规模下降
根据Light Origins的说法,在三个数据集上,预测误差都随着预训练增加而下降。公司称结果遵循幂律趋势,更大规模的人类动作预训练为下游适配提供了更强的起点。Light Origins强调,报告的机器人结果仍然使用目标特定数据,规模测试测量的是留出的下一动作和全身姿态预测,而不是真实世界任务成功率。
用人类视频学习
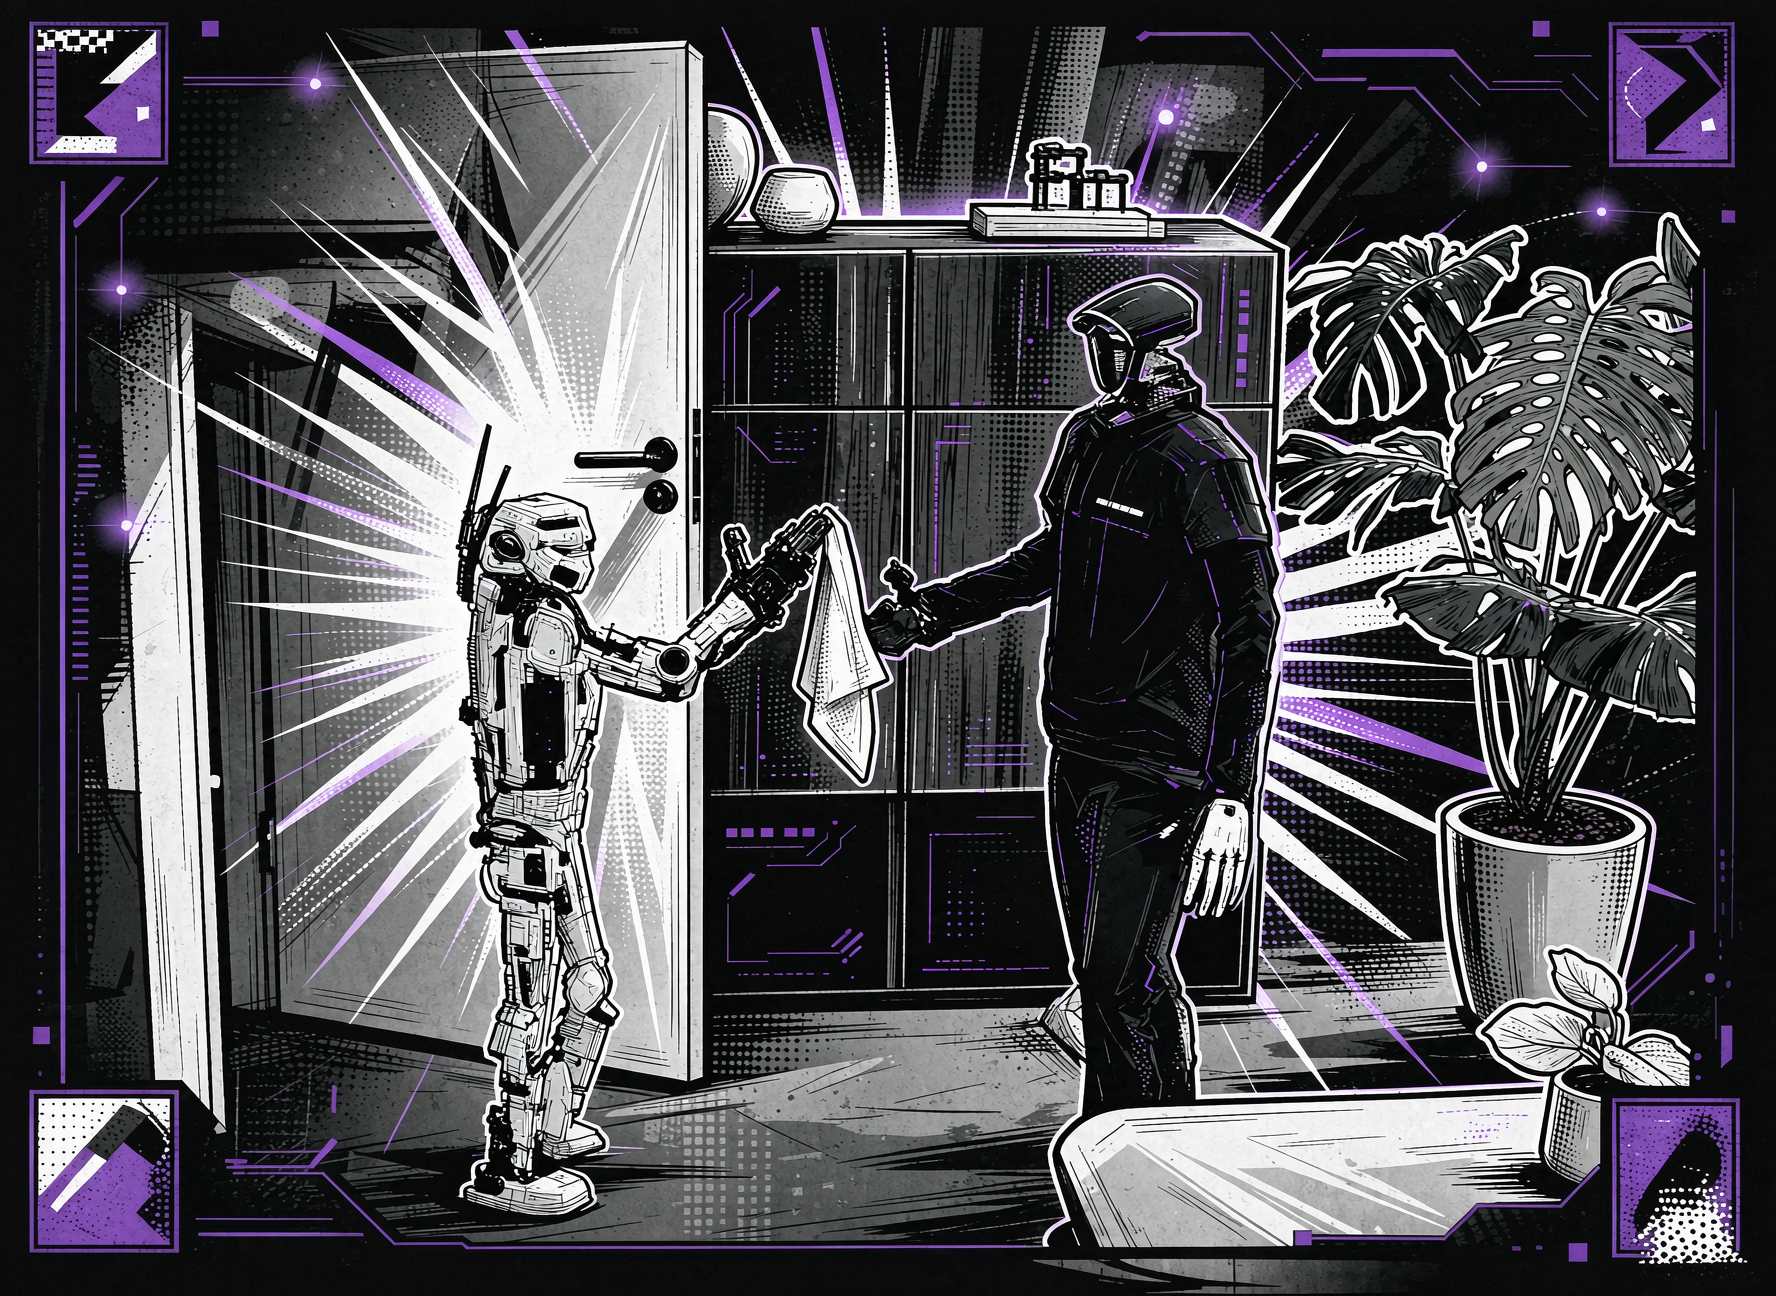
Light Origins不是完全依赖机器人生成的数据,而是从互联网视频中提取结构化的3D人类动作,并将它们与视觉信息和语言对齐。模型在适配到机器人之前学习物理行为的重复模式。在演示中,Light-O1执行了几项任务:LightBot打开鞋柜并把拖鞋放进去;人形机器人捡起不同类型的垃圾,包括物品在任务过程中被移动时;LightBot完成毛巾交接;宇树G1擦拭桌子并在同一演示中接过毛巾。公司称其数据基础设施现在运行在千GPU规模,每周处理约20万小时视频,六个月前为12500小时。
物理AI路线图
Light Origins围绕可扩展预训练、对齐和部署三个领域组织其开发,Light-O1代表预训练阶段。本月早些时候,公司推出了用于对齐的LightNav-0。其Real2Sim2Real系统将2000多个互联网来源场景转换为模拟环境,产生超过4000小时导航经验。生成的模型无需额外训练即可泛化到人形、四足、空中和轮式机器人。对于部署,Light Origins使用Light REACT,一个旨在帮助机器人根据最近物理交互调整行为的系统。它使用这些上下文来估计外力、硬件损伤和环境约束,然后调整全身运动。